Hugging Face: Evaluasi AI Perlu Standar yang Lebih Seragam
CIANJUR.CO - Laboratorium kecerdasan buatan (AI) selama ini menaruh reputasi pada hasil benchmarking model. Pengujian tersebut dimaksudkan untuk mengukur apakah satu produk AI lebih baik daripada produk lain, dan kerap diperlakukan sebagai metode yang netral serta akurat. Namun, cara menjalankan dan membaca evaluasi itu masih rumit, sementara ilmunya belum mapan.
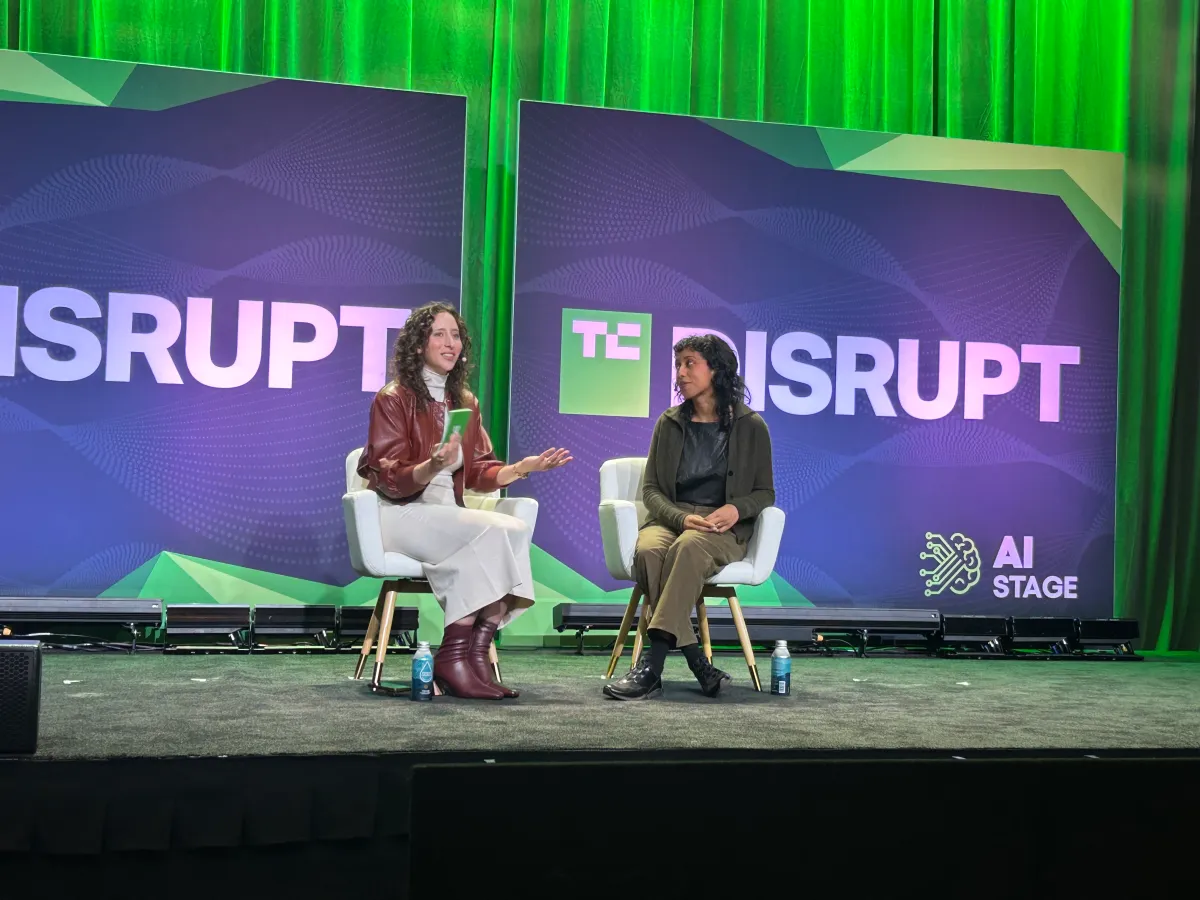
Hal tersebut disampaikan Irene Solaiman, kepala kebijakan Hugging Face, dalam diskusi di TechCrunch Disrupt pekan lalu. Berdasarkan laporan TechCrunch AI, Solaiman menilai pengujian perlu berkembang menjadi ilmu yang lebih konsisten apabila industri ingin mengandalkannya pada masa mendatang. Karena itu, kepercayaan terhadap hasil tes yang beredar saat ini masih perlu dilihat dengan mempertimbangkan cara hasil tersebut diperoleh.
Solaiman mengingatkan bahwa kata “percaya” memiliki bobot dan tidak cukup dijawab hanya dengan melihat skor akhir sebuah model. Salah satu pertanyaan penting, menurutnya, adalah apakah hasil evaluasi dapat direproduksi. Pengulangan pengujian yang menghasilkan temuan serupa menjadi bagian penting untuk menilai seberapa dapat diandalkan hasil yang diumumkan.
Akses terhadap model juga menentukan apakah pengujian bisa diperiksa dan diulang. Solaiman menyoroti peran akses yang memadai terhadap model itu sendiri, termasuk model dengan bobot terbuka. Ketersediaan akses semacam itu berkaitan dengan kemampuan pihak lain untuk menguji hasil, bukan sekadar menerima angka yang disampaikan oleh pembuat model.
Baca juga: Microsoft: Agen AI Perlu Diawasi seperti Ancaman Orang Dalam
Reproduksibilitas sudah lama menjadi salah satu persoalan yang sulit diselesaikan dalam benchmarking dan masih diperdebatkan di industri. Selain menilai apakah satu tes tertentu valid, ada persoalan lain: bagaimana hasil tes tersebut dapat dibandingkan dengan evaluasi yang berbeda. Menurut Solaiman, evaluasi AI masih berkembang dan belum ada cara yang benar-benar bermakna untuk memperbandingkan satu metode dengan metode lainnya.
Masalahnya, evaluasi juga dapat kehilangan daya guna dalam waktu relatif cepat. Solaiman menyebut ekosistem pengujian yang tersedia belum cukup berkembang untuk memenuhi kebutuhan. Di saat yang sama, muncul minat terhadap ekosistem evaluator yang tertanam di dalam organisasi AI. Namun, penentuan pihak yang layak menjadi evaluator dan tugas apa saja yang dapat dinilai secara efektif masih membutuhkan standardisasi lebih kuat.
Gagasan evaluator tertanam merujuk pada pengamat pihak ketiga yang ditempatkan di dalam organisasi AI, meskipun mereka disebut sebagai pihak yang “netral”. Konsep ini semakin populer dalam beberapa bulan terakhir, ketika laboratorium AI menghadapi sejumlah insiden keselamatan yang memicu kekhawatiran mengenai potensi dampak teknologi mereka. Hugging Face sendiri pernah menjadi sasaran salah satu insiden tersebut.
Laboratorium AI mendorong penggunaan evaluator pihak ketiga sebagai alternatif dari regulasi pemerintah yang aktif untuk mengenali dan mengurangi risiko keselamatan model. Akan tetapi, pendekatan itu belum menghapus keraguan mengenai seberapa netral dan efektif evaluator yang ditunjuk. Penempatan pihak luar di dalam organisasi tidak dengan sendirinya memastikan bahwa penilaian mereka memenuhi kualifikasi atau bebas dari persoalan yang dipertanyakan.
Baca juga: Amazon Rilis TorchNeuron untuk Bawa Aplikasi AI ke Chip Trainium
Perdebatan itu terlihat ketika Anthropic menunjuk Accenture sebagai evaluator pertamanya. Keputusan tersebut memicu cukup banyak kritik. Sebagian pengkritik bahkan mengejek anggapan bahwa perusahaan konsultan itu memiliki kualifikasi untuk menjalankan tugas yang dimaksud. Reaksi itu menunjukkan bahwa siapa yang menilai model juga menjadi bagian dari persoalan kepercayaan, bukan hanya metode pengujiannya.
Ruang lingkup evaluasi pun bergerak melampaui pengujian model secara terpisah. Penilaian kini mencakup keseluruhan sistem di sekitar model, termasuk harness dan agen. Harness adalah alat yang digunakan pengguna untuk mengakses model, sehingga kinerja yang terlihat tidak hanya ditentukan oleh kemampuan model itu sendiri. Dalam diskusi tersebut, Solaiman menyampaikan bahwa model yang lebih lemah dengan harness lebih baik dapat dengan mudah mengungguli model frontier.
Perubahan fokus itu membuat perbandingan antarmodel menjadi lebih kompleks. Jika alat akses turut memengaruhi performa, skor sebuah model tidak selalu menggambarkan kemampuan model secara terisolasi. Pengujian perlu memperhitungkan sistem yang digunakan dan bagaimana sistem tersebut berinteraksi dengan model. Namun, pembahasan Solaiman juga menunjukkan bahwa ketersediaan evaluasi untuk setiap bagian sistem belum seimbang.
Baca juga: Kebocoran OpenCode Console Picu Tagihan AI Tak Sah
“Evaluasi agentik benar-benar sulit dan sangat mahal,” kata Solaiman. Ia menjelaskan bahwa evaluasi untuk model jumlahnya lebih banyak, sedangkan pengujian untuk harness belum sebanyak itu. Pada saat yang sama, pengembangan evaluasi yang lebih baik untuk agen secara menyeluruh masih berlangsung, karena banyak pengguna memperoleh manfaat dari sistem agen tersebut.
Dengan demikian, tantangan benchmarking mencakup beberapa lapis: hasil tes harus dapat direproduksi, metode yang berbeda perlu memiliki dasar perbandingan yang lebih jelas, dan penilai pihak ketiga membutuhkan kualifikasi yang terstandar. Ketika evaluasi mulai mencakup model, harness, dan agen sekaligus, kebutuhan akan metode yang sesuai untuk tiap bagian juga semakin terlihat. Solaiman menilai ekosistem saat ini masih belum memiliki jumlah dan konsistensi pengujian yang dibutuhkan.
Evaluasi AI saat ini, sebagaimana tergambar dalam pemaparan Solaiman, masih berjalan dengan pendekatan yang beragam dan belum memiliki kesepahaman industri yang kuat. Agar benchmarking tetap dipandang berguna oleh para pemimpin industri, diperlukan pendekatan yang lebih seragam sehingga pihak-pihak yang terlibat dapat menggunakan dasar penilaian yang sama. Kebutuhan tersebut mencakup bukan hanya cara menguji, tetapi juga cara membandingkan hasil dan menetapkan siapa yang efektif untuk melakukan evaluasi.